Development of an automated data collection system from online stores
Разработка системы автоматизированного сбора данных из интернет-магазинов
Цель – разработка системы автоматизированного сбора и обработки данных о товарах интернет-магазинов, обеспечивающей полный локальный контроль, гибкость настройки и масштабируемость.
Методы – выявлены недостатки существующих решений и сформулированы ключевые требования: локальное хранение данных, асинхронная параллельная обработка, визуальный интерфейс настройки без программирования, экспорт в стандартные форматы. Спроектирована многоуровневая архитектура десктопного приложения для Windows. Реализован интерфейс, охватывающий полный цикл: создание конфигураций через встроенный браузер с автоматическим формированием CSS-селекторов, параллельный сбор основного и детального уровней данных, просмотр и редактирование, нормализация и экспорт в XLSX, CSV, JSON. Предусмотрены регулируемые задержки и степень параллелизма для адаптации к разным сайтам.
Результаты – система протестирована на реальных каталогах, подтверждена работоспособность всех функциональных блоков. Обеспечена возможность гибкой настройки под структуру произвольного интернет-магазина без привлечения программистов.
Выводы – разработанное решение готово к промышленному внедрению; его использование позволит существенно сократить трудозатраты на мониторинг рыночных цен и ассортимента, повысить оперативность получения аналитических данных и снизить зависимость от сторонних сервисов.
The goal is to develop a system for automated collection and processing of data on products from online stores, ensuring full local control, flexibility in configuration, and scalability.
Methods: the shortcomings of existing solutions were identified, and key requirements were formulated: local data storage, asynchronous parallel processing, a visual configuration interface without programming, and export to standard formats. A multi‑level architecture of a desktop application for Windows has been designed. An interface has been implemented that covers the full cycle: creating configurations via a built‑in browser with automatic generation of CSS selectors, parallel collection of main and detailed data levels, viewing and editing, normalization, and export to XLSX, CSV, and JSON. Adjustable delays and the degree of parallelism are provided to adapt to different websites.
Results: the system has been tested on real catalogs, and the functionality of all functional blocks has been confirmed. The system provides the ability to flexibly configure it to fit the structure of any online store without involving programmers.
Conclusions: the developed solution is ready for industrial implementation; its use will significantly reduce labor costs associated with monitoring market prices and product offerings, improve the speed of obtaining analytical data, and reduce dependence on third‑party services.
информационная система, автоматизированный сбор данных, веб-скрапинг, парсинг, интернет-магазин, нормализация данных.
information system, automated data collection, web scraping, parsing, online store, data normalization.
Введение. В открытом доступе сети Интернет присутствуют значительные объёмы ценной информации, имеющей нерегулярную структуру и специфические способы доступа, ориентированные на человека. Эффективный сбор и систематизация таких данных становятся важной задачей для организаций различных сфер деятельности. Одним из ключевых источников являются интернет-магазины: мониторинг ассортимента и цен конкурентов приобретает повышенное значение в условиях активного развития электронной коммерции [1-4].
Ручной сбор и обработка данных крайне трудоёмки и неэффективны из-за больших объёмов и постоянного обновления информации. Технологии автоматизации позволяют решить проблему масштабируемости, однако их создание сопряжено с техническими сложностями, а существующие системы часто заточены под конкретные задачи или типы ресурсов, что ограничивает их применимость для разнородных интернет-магазинов [5-8]. В связи с этим актуальна разработка собственной системы, лишённой перечисленных недостатков.
Методы. На основе анализа предметной области и существующих решений сформулированы ключевые требования к разрабатываемой системе [9-15]. Например, полный локальный контроль над данными – агрегированная база сведений о ценах и ассортименте имеет коммерческую ценность, поэтому её передача сторонним провайдерам недопустима. Система не должна зависеть от внешних сервисов ни на этапе сбора, ни на этапе хранения.
Производительность – локальная система должна обеспечивать приемлемое время выполнения за счёт собственных ресурсов. Последовательная обработка каталогов с тысячами позиций невозможна, поэтому реализована асинхронная параллельная обработка запросов.
Работа с динамическим контентом – большинство современных интернет-магазинов формирует страницы с помощью JavaScript, что исключает простой разбор статического HTML. Система использует полноценный браузерный движок, выполняющий JavaScript и взаимодействующий со страницей подобно обычному пользователю.
Доступность для непрограммистов – настройку правил извлечения выполняют сотрудники отдела закупок, поэтому интерфейс должен позволять конфигурировать и корректировать правила без привлечения IT-специалистов, особенно с учётом периодических изменений структуры страниц.
Масштабируемость – система должна обеспечивать добавление новых источников через визуальный интерфейс без изменения кода и сохранять устойчивую работу при росте нагрузки.
Экспорт и нормализация – результаты должны выгружаться в форматы, совместимые с существующими инструментами анализа (XLSX, CSV, JSON), с возможностью нормализации для исключения дополнительной ручной обработки.
В соответствии с требованиями система реализована как десктопное приложение для Windows 10/11 с многоуровневой архитектурой (уровень представления, бизнес-логики и данных), что обеспечивает независимость компонентов и возможность дальнейшего развития. В основу концепции положены три принципа: полный локальный контроль, доступность через визуальное конфигурирование, и производительность за счёт параллельной обработки.
Результаты. Пользовательский интерфейс системы реализован в виде десктопного приложения для операционной системы Windows и включает главное окно с панелью вкладок, встроенный браузер конфигурирования и набор диалоговых окон. Описание интерфейса выполнено на примере полного цикла работы с системой – от создания конфигурации сбора для магазина «Трейд партс» на маркетплейсе Ozon до получения нормализованного и экспортированного набора данных.
При запуске приложения открывается главное окно, представленное на рис. 1. В верхней части окна расположена панель с пятью вкладками: «Конфигурирование», «Запуск», «Просмотр», «Настройки» и «О программе». Слева от вкладок находится кнопка «Браузер», запускающая встроенный браузер конфигурирования. Рабочая область окна разделена вертикальным разделителем на левую навигационную панель и правую область с содержимым активной вкладки.
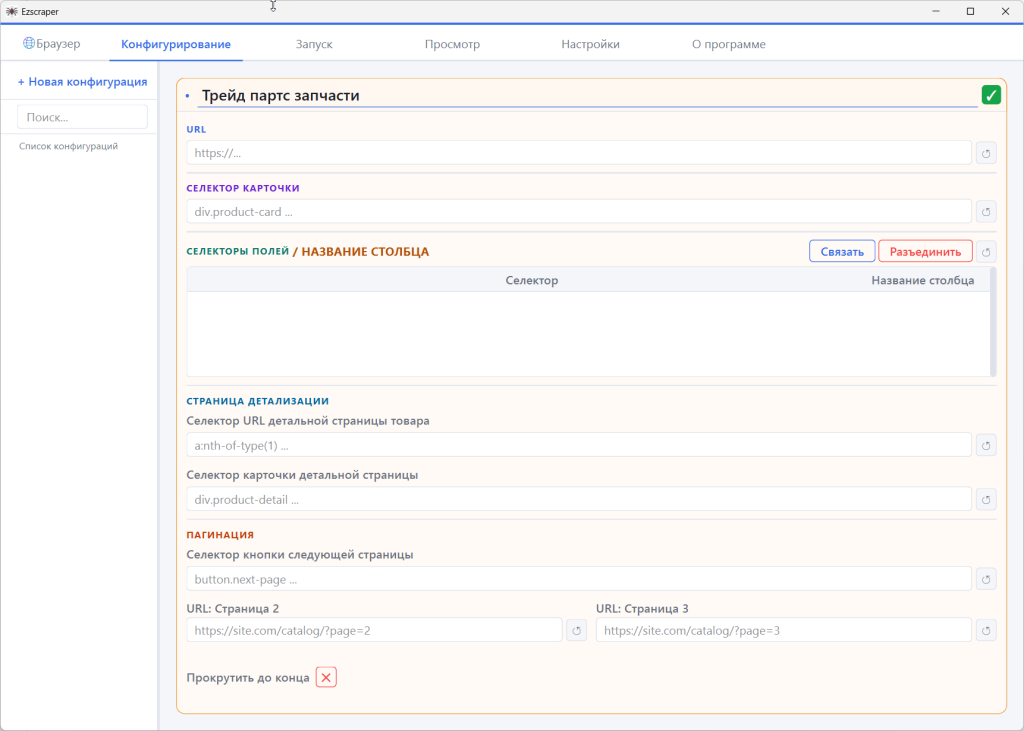
Рис. 1 – Вкладка «Конфигурирование» с пустой формой
Левая навигационная панель содержит поле поиска, список конфигураций, сгруппированных по доменам, и кнопку создания новой конфигурации. Поведение панели изменяется в зависимости от активной вкладки: в режиме «Конфигурирование» клик по конфигурации открывает её параметры; в режиме «Просмотр» – загружает собранные данные по сессиям выбранной конфигурации для просмотра и редактирования; в режиме «Настройки» – открывает форму глобальных настроек или переопределения параметров для выбранного домена либо конфигурации.
Для создания новой конфигурации нажимается кнопка «+ Новая конфигурация» на левой навигационной панели. Активируется вкладка «Конфигурирование» с пустой формой, представленной на рис. 1.В верхнем поле формы указывается произвольное название конфигурации – в данном примере «Трейд партс запчасти». Остальные поля заполняются нажатием кнопок автозаполнения, расположенными рядом с каждым полем: они передают актуальные значения непосредственно из браузера конфигурирования.
Для запуска браузера конфигурирования нажимается кнопка «Браузер» в верхней панели главного окна. В отдельном окне открывается встроенный браузер, в котором после загрузки каждой страницы автоматически внедряется JavaScript-интерфейс конфигурирования. В адресную строку вводится URL целевого каталога – в данном примере страница каталога запасных частей магазина Трейд Партс на маркетплейсе Ozon. После загрузки страницы в верхней части браузера появляется панель инструментов с кнопками режимов выбора. Браузер с загруженной страницей и активной панелью инструментов представлен на рисунке 2.
Для выбора карточки товара активируется режим «Выбрать карточку» на панели инструментов. При наведении курсора на элементы страницы они подсвечиваются цветной рамкой. После клика на любую из карточек товара в каталоге система формирует CSS-селектор выбранного элемента и заменяет все аналогичные карточки прокси-карточками – блоками, в которых весь текст исходного элемента преобразуется в отдельные строки, доступные для выбора.
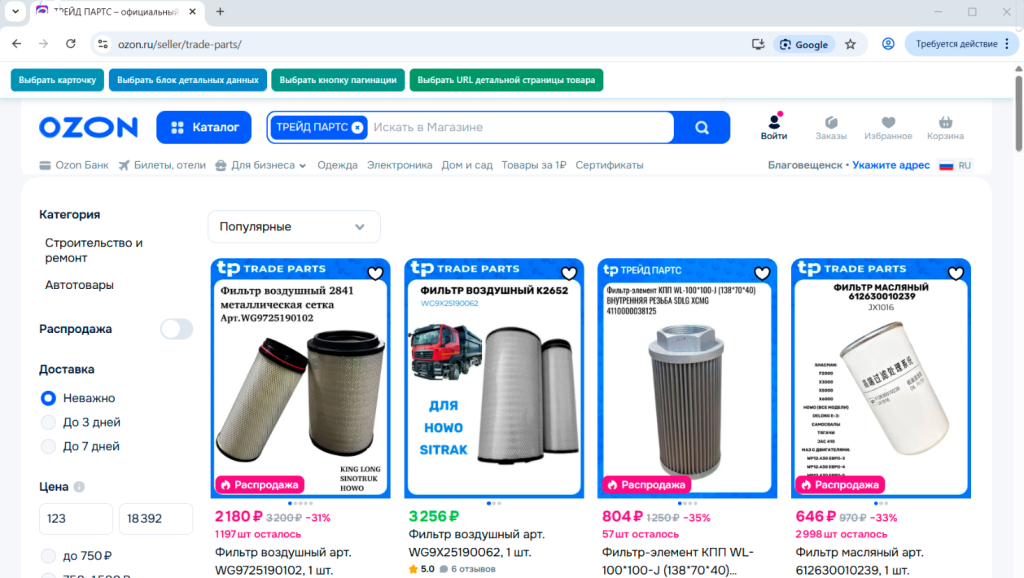
Рис. 2 – Браузер конфигурирования с панелью инструментов
Сформированный CSS-селектор карточки переносится на вкладку «Конфигурирование» нажатием соответствующей кнопки автозаполнения. Аналогичным образом, активировав режим «Выбрать URL детальной страницы товара» и кликнув на ссылку в одной из прокси-карточек, определяется CSS-селектор ссылки на страницу отдельного товара.
Выбор полей для извлечения осуществляется кликом на нужные строки непосредственно в прокси-карточках. После завершения выбора нажимается кнопка «Получить поля» рядом с таблицей полей на вкладке «Конфигурирование» – таблица заполняется строками с CSS-селекторами. Названия столбцов для каждого поля вводятся вручную – например, «Название», «Артикул», «Цена».
Вспомогательный режим «Анализ полей» позволяет просмотреть все обнаруженные селекторы полей по всем прокси-карточкам, а также долю карточек, в которых присутствует каждое конкретное поле. Процесс выбора полей на прокси-карточке представлен на рисунке 3.
Для конфигурирования детального сбора в браузере открывается страница одного из товаров. После загрузки интерфейс внедряется повторно. Активируется режим «Выбрать блок детальных данных» и производится клик на блок с характеристиками товара. Сформированный CSS-селектор переносится в соответствующееполе нажатием кнопки автозаполнения.
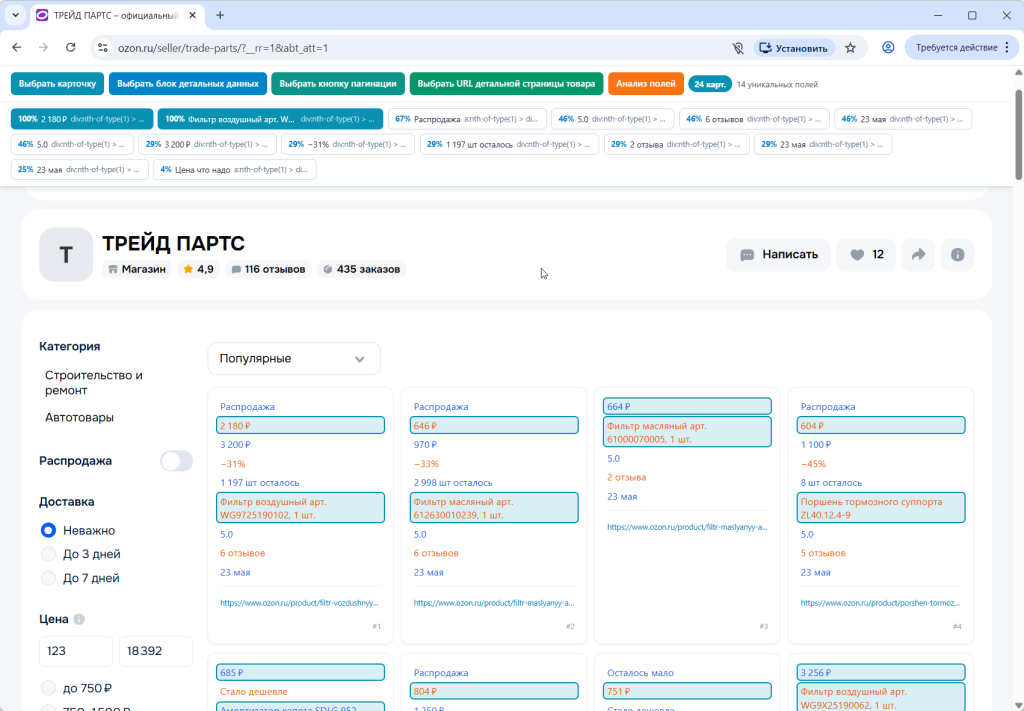
Рис. 3 – Выбор полей для извлечения в прокси-карточке товара
После заполнения всех полей конфигурация сохраняется нажатием кнопки «Сохранить» и появляется в левой навигационной панели в группе соответствующего домена.
Параметры сбора настраиваются на одноимённой вкладке и включают следующие разделы:
– «Задержки» – управляет временем ожидания после загрузки страницы и после перехода на следующую, а также максимальным числом обрабатываемых страниц;
– «Скроллинг» – задаёт шаг прокрутки в пикселях, паузу между шагами и максимальное время ожидания завершения прокрутки;
– «Параллельность» – определяет, сколько доменов, конфигураций и вкладок обрабатывается одновременно.
Настройки организованы в трёх уровнях: глобальные значения применяются ко всем конфигурациям, однако могут быть переопределены для конкретного домена или отдельной конфигурации. Увеличение задержек в сочетании со снижением степени параллелизма позволяет снизить интенсивность запросов и обойти защиту от автоматизированного доступа на сайтах с соответствующими ограничениями. На ресурсах без подобных ограничений сокращение задержек и увеличение параллелизма позволяет существенно ускорить сбор.
Для запуска основного сбора данных осуществляется переход на вкладку «Запуск». Конфигурация «Трейд Партс – запчасти» выбирается в левой панели и добавляется в очередь с типом сбора «Основной». После нажатия кнопки «Запустить» система открывает браузер, загружает стартовую страницу каталога и приступает к циклическому обходу страниц. В нижней части вкладки ведётся журнал выполнения с отображением хода сбора в реальном времени. Кнопка «Остановить» позволяет прервать сбор в любой момент; уже собранные данные при этом сохраняются в полном объёме. Окно приложения в процессе основного сбора представлено на рисунке 4.
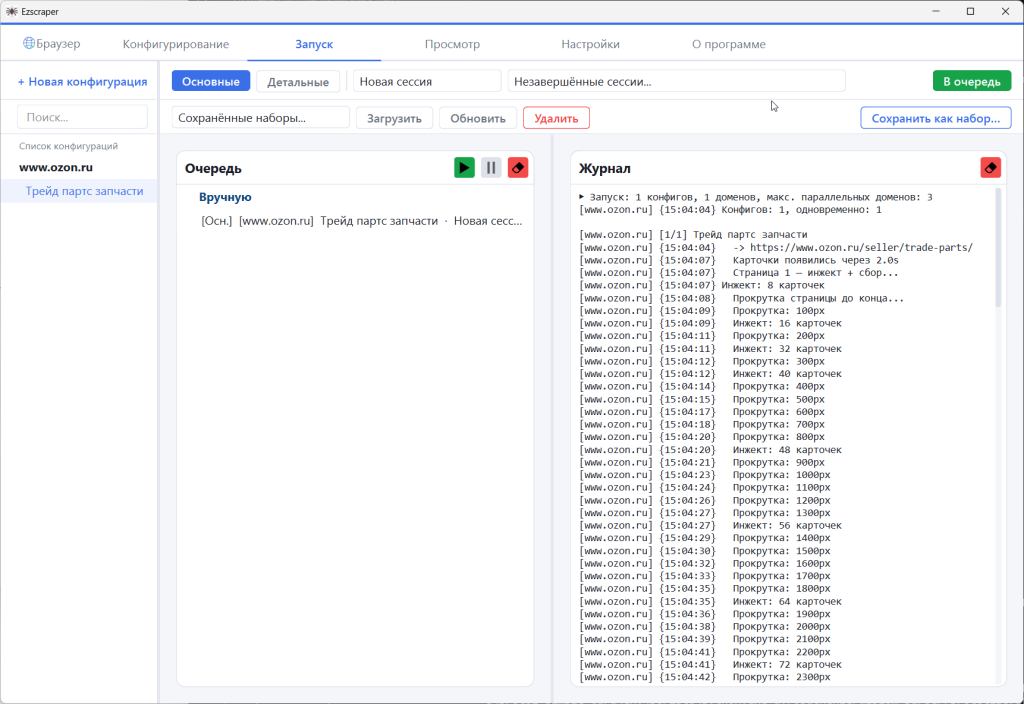
Рис. 4 – Окно приложения в процессе основного сбора данных
По завершении сессии осуществляется переход на вкладку «Просмотр». После выбора сессии в режиме «Основные» таблица заполняется собранными данными карточек товаров: столбцы соответствуют полям, заданным в конфигурации, а также содержат URL страницы-источника. Содержимое ячеек доступно для редактирования, строки и сессии могут быть удалены.
На основе результатов основного сбора запускается детальный сбор. На вкладке «Запуск» конфигурация добавляется в очередь с типом «Детальный», из выпадающего списка выбирается исходная основная сессия. После запуска система извлекает из базы данных все URL-адреса страниц товаров и обходит их в параллельных вкладках браузера. В журнале отображается порядковый номер текущего URL из общего количества, адрес страницы и статус обработки. Прерванная сессия может быть возобновлена без повторной обработки уже пройденных страниц.
При необходимости структурирования данных нажимается кнопка «Нормализовать», после чего открывается диалог нормализации. Результат отображается в режиме «Нормализованные» на вкладке «Просмотр»: таблица приобретает единообразную структуру с именованными столбцами, пригодную для дальнейшей обработки в специализированных программах, таких как Microsoft Excel, а также для последующего анализа данных. При этом поддерживаются три формата: XLSX, CSV и JSON.
Таким образом, пользовательский интерфейс системы обеспечивает полный цикл работы с данными: визуальное конфигурирование правил извлечения через встроенный браузер с автоматическим формированием CSS-селекторов, управление очередями заданий и запуск основного и детального сбора с отображением хода выполнения в реальном времени, просмотр и редактирование собранных данных в табличном представлении, нормализация детальных характеристик товаров с назначением псевдонимов и экспорт результатов. Все этапы реализованы в рамках единого приложения и доступны через интуитивно понятный интерфейс, не требующий от пользователя знания веб-технологий или программирования. Работоспособность системы подтверждена в соответствии с критериями приёмо-сдаточных испытаний технического задания.
Обсуждение. Разработанное решение позволяет преодолеть основные недостатки коммерческих аналогов: обеспечен полный локальный контроль над данными, реализована асинхронная параллельная обработка, а визуальный интерфейс конфигурирования делает систему доступной для сотрудников без технической подготовки. В отличие от облачных сервисов, данные не передаются сторонним провайдерам, что исключает риски утечки коммерчески ценной информации. Гибкая настройка задержек и параллелизма позволяет адаптироваться к различным сайтам — от высоконагруженных маркетплейсов до ресурсов с агрессивной антибот-защитой. Многоуровневая архитектура обеспечивает лёгкость расширения функционала.
Однако система имеет ограничения: эффективность сбора зависит от стабильности работы целевых сайтов и их защиты от автоматических запросов; при значительном изменении структуры страниц может потребоваться перенастройка селекторов. В перспективе планируется расширение числа экспортных форматов, интеграция со средствами бизнес-аналитики и совершенствование механизмов обхода антибот-защиты.
Внедрение разработанной системы позволит сократить трудозатраты на мониторинг рынка, повысить оперативность обновления информации об ассортименте и ценах конкурентов, исключить зависимость от дорогостоящих облачных сервисов, что подтверждает практическую значимость и целесообразность разработки.
References
1. Парсинг данных: лучшие сервисы для веб-скрапинга [Электронный ресурс]. – URL: https://www.reg.ru/blog/parsing-dannyh-luchshie-servisy-dlya-veb-skrapinga/ (дата обращения: 01.08.2026).
2. Уколов А. Н. Веб-скрапинг: возможности, методы и инструменты [Электронный ресурс] // Молодой учёный. – 2024. – № 30 (529). – С. 29–31. – URL: https://moluch.ru/archive/529/116859/ (дата обращения: 03.07.2026).
3. Web scraping вашего сайта: непрошеные гости и как их встречают [Электронный ресурс] // Хабр : блог компании Qrator Labs. – 2020. – URL: https://habr.com/ru/company/qrator/blog/513014/ (дата обращения: 01.08.2026).
4. 15 топовых веб-скрапинг решений 2021 года [Электронный ресурс] // Хабр. – 2021. – URL: https://habr.com/ru/articles/543760/ (дата обращения: 01.08.2026).
5. 30+ парсеров для сбора данных с любого сайта [Электронный ресурс] // Хабр. – 2020. – URL: https://habr.com/ru/companies/click/articles/494020/ (дата обращения: 01.08.2026).
6. Парсинг сайтов: что это и как работает + 9 способов применения [Электронный ресурс]. – 2019. – URL: https://q-parser.ru/blog/what-is-parsing (дата обращения: 01.08.2026).
7. 12 парсеров для сбора данных с сайтов, которые можно использовать, не нарушая закон [Электронный ресурс]. – 2025. – URL: https://www.unisender.com/ru/blog/parsery-dlya-sbora-dannyh-s-sajtov/ (дата обращения: 01.08.2026).
8. Андрюхин В. Парсинг HTML: как извлекать данные с сайта автоматически [Электронный ресурс]. – 2025. – URL: https://workspace.ru/blog/parsing-html-kak-izvlekat-dannye-s-sayta-avtomaticheski/ (дата обращения: 01.08.2026).
9. Яценко А. Парсинг сайта вместе с Python и библиотекой Beautiful Soup: простая инструкция в три шага [Электронный ресурс] // Skillbox Media: Код. – 2022. – URL: https://skillbox.ru/media/code/parsing-sayta-vmeste-s-python-i-bibliotekoy-beautiful-soup-prostaya-instruktsiya-v-tri-shaga/ (дата обращения: 03.07.2026).
10. Корнелюк А. Что такое парсинг, и что о нём нужно знать маркетологам [Электронный ресурс]. – URL: https://marquiz.ru/blog/chto-takoe-parsing/ (дата обращения: 03.07.2026).
11. Геоэффект бизнес: Идеальная локация для бизнеса за 5 минут [Электронный ресурс]. – URL: https://business.mts.ru/moskva/geoeffekt-biznes (дата обращения: 07.08.2026).
12. Что такое парсер: виды, задачи и настройка для сбора данных с сайтов [Электронный ресурс]. – URL: https://journal.zennolab.com/data-parsing-how-to-parse-websites/ (дата обращения: 07.08.2026).
13. ParseHub: официальный сайт [Электронный ресурс]. – URL: https://www.parsehub.com/ (дата обращения: 07.08.2026).
14. WebHarvy: официальный сайт [Электронный ресурс]. – URL: https://www.webharvy.com/(дата обращения: 07.08.2026).
15. Диггернаут: официальный сайт [Электронный ресурс]. – URL: https://www.diggernaut.ru/ (дата обращения: 07.08.2026).